Il riconoscimento automatico e la validazione contestuale delle entità semantiche rappresentano oggi il fulcro della governance linguistica nei documenti tecnici italiani, soprattutto quando si opera a livello Tier 2 e si aspira a un livello Tier 3 di precisione e affidabilità. Mentre il Tier 2 fornisce metodi strutturati per l’estrazione automatica—basati su regole linguistiche, modelli ML supervisionati e ontologie di settore—l’evoluzione verso il Tier 3 richiede una validazione approfondita contestuale, disambiguazione semantica e integrazione di grafi della conoscenza specifici, come quelli del settore industriale italiano. Questo articolo esplora passo dopo passo una metodologia esperta per implementare un sistema di controllo qualità semantico automatico, partendo dalle basi del Tier 2 e progredendo verso tecniche avanzate di disambiguazione e validazione contestuale, con esempi reali tratti da documentazione tecnica italiana, strumenti open source e best practice aziendali.
—
Fondamenti del riconoscimento contestuale delle entità semantiche nel contesto tecnico italiano
Nel dominio tecnico italiano, le entità semantiche comprendono componenti di macchinari, processi produttivi, procedure operative, normative di riferimento e terminologia specializzata, spesso ricca di ambiguità lessicale e varianti dialettali. Il riconoscimento automatico non può limitarsi a pattern lessicali statici ma deve integrare il contesto linguistico, sintattico e pragmatico. Ad esempio, “RAM” in un manuale di calcolo può indicare RAM di memoria o un modello meccanico, a seconda del contesto: “Il RAM del server è stato aggiornato” vs “Il RAM meccanico richiesto è compatibile”. Questo richiede un approccio ibrido, combinando modelli NER basati su linguaggi formali (NFG, regole morfosintattiche) e modelli NLP addestrati su corpus tecnici italiani, che catturano le peculiarità lessicali e sintattiche del settore.
Fase 1: l’estrazione inizia con la preparazione di un corpus annotato
La qualità del Tier 2 dipende dalla qualità del dataset: è fondamentale costruire un corpus di riferimento che includa entità chiave (componenti, processi, norme) associate a etichette semantiche e contesti annotati. Per il settore industriale italiano, questo corpus può derivare da manuali tecnici, normative (es. UNI, ISO 15926), report tecnici aziendali e documentazione CMS. Ad esempio, un dataset per la documentazione di impianti di automazione può includere frasi come “Il valvolino di sicurezza RAM-12 è stato sostituito secondo la norma UNI 8001”, dove “RAM-12” è una entità tecnica da riconoscere e validare contestualmente.
L’annotazione deve essere effettuata da linguisti tecnici e ingegneri, seguendo linee guida standardizzate (ad es. ISO 2382-3) per garantire coerenza lessicale e grammatica. L’uso di strumenti come spaCy con annotazioni personalizzate (custom NER) permette di addestrare modelli su questi dati specifici, migliorando la precisione nel riconoscimento di entità non standardizzate.
—
Metodologie di estrazione automatica: Tier 2 vs Tier 3
“L’estrazione semantica automatica in italiano non può prescindere da un approccio stratificato: base regolare + contesto contestuale + validazione ontologica”
Il Tier 2 si basa su pipeline integrate tra regole linguistiche e modelli ML supervisionati. Ad esempio, un pipeline tipico utilizza spaCy con modello `it-crawl-bert` fine-tunato su testi tecnici, integrato con un `CurativeEntityRecognizer`, un entità custom trainato per riconoscere termini tecnici (es. “valvolino di sicurezza”, “procedura di manutenzione”). Questo modello riconosce entità nominali attraverso pattern lessicali, regole morfologiche (es. prefissi “RAM-”, “SEN-”) e vincoli sintattici (soggetti o complementi specifici).
Tuttavia, le limitazioni emergono in contesti ambigui o tecnici regionali: ad esempio, “ciclo di raffreddamento” può riferirsi a processi diversi in impianti chimici o meccanici. Qui il Tier 3 interviene con disambiguazione semantica avanzata.
**Fase 3: validazione contestuale tramite ontologie di settore**
Per il settore industriale italiano, l’integrazione con grafi della conoscenza come Wikidata Italia, GeoNames Italia e ontologie ISO 15926 consente di arricchire il contesto entità. Ad esempio, l’entità “RAM-12” può essere collegata a una classe gerarchica (componenti → valvolini di sicurezza → fluidi), a processi (installazione, test di tenuta), e a normative di riferimento. Questa validazione contestuale riduce il tasso di falsi positivi e migliora la fedeltà semantica.
Fase 4: generazione di output strutturato con punteggio di fiducia
Il risultato è un JSON annotato per ogni entità:
{
“text”: “Il valvolino RAM-12 è stato sostituito secondo UNI 8001”,
“entity”: “RAM-12”,
“type”: “componente”,
“category”: “valvolino di sicurezza”,
“source_context”: “UNI 8001”,
“confidence_score”: 0.94,
“fuzzy_matches”: [
{“possible”: true, “confidence”: 0.78, “context”: “sostituzione componente”,
“context”: “procedura manutenzione”
]
}
Questo output è cruciale per sistemi CMS professionali o dashboard di quality assurance, consentendo audit automatici e tracciabilità delle modifiche semantiche.
—
Errori comuni e tecniche di risoluzione nel Tier 2 automatizzato
Attenzione: sovra-estrazione di entità indistinte
Un errore frequente è l’estrazione errata di termini simili ma non pertinenti: ad esempio, “RAM” in “RAM elettrico” vs “RAM meccanico” in un manuale di impianti. La soluzione richiede filtri contestuali basati su co-occorrenze: ad esempio, limitare l’estrazione a entità seguite da “di sicurezza”, “installazione” o “manutenzione”, tipici contesti tecnici italiani.
Gestione dell’ambiguità lessicale
Il termine “RAM” in ambito IT (RAM di memoria) vs meccanico (RAM di raffreddamento) richiede disambiguazione semantica tramite co-linguistica. Ad esempio, la presenza di parole chiave come “fluido”, “pressione” o “componento” nel contesto sintattico riduce l’ambiguità. Implementare un sistema di regole basato su co-occorrenze e analisi delle dipendenze sintattiche (tramite spaCy) migliora il tasso di precisione.
Incoerenza lessicale e varianti dialettali
La terminologia italiana presenta varianti regionali: “valvolino” è comune nel nord, “valvula” nel centro/sud. Per evitare duplicazioni e incoerenze, standardizzare l’uso con un glossario tecnico ufficiale (es. Glossario Tecnico INI) e applicare normalizzazione lessicale (es. mappatura automatica tramite regole o modelli).
Falsi positivi in contesti tecnici
Elencare entità in contesti non tecnici è un problema noto. Esempio: “il RAM è stato installato sul computer” è un falso positivo. Implementare liste bianche di contesti esclusi (es. “documentazione IT”, “manuali prodotto”) e regole di negazione contestuale (“non applicabile a configurazioni software”) riduce gli errori.
**Consiglio operativo:** creare un “filtro di contesto” che blocca entità estratte in testi non tecnici o con bassa probabilità sintattica (es. frasi nominali senza verbo attivo).
—
Ottimizzazione avanzata per ambienti italiani: dati, dialetti e integrazione CMS
Adattamento ai dialetti e varianti regionali
Sebbene l’italiano standard sia predominante, nel settore industriale regionale persistono termini dialettali: ad esempio, “valvola” in Lombardia vs “valvula” in Sicilia. Un sistema di preprocessing può includere un dizionario multilingue e mappature contestuali per riconoscere entità anche in forma variante, migliorando la copertura senza sacrificare coerenza.
Performance e pipeline distribuite
Per grandi volumi (migliaia di documenti), ottimizzare il pipeline con caching contestuale e parallelizzazione tramite pipeline di Spark o workflow Python (ej. Dask). Usare modelli leggeri (es. distilBERT fine-tunato) per ridurre latenza e consumo di risorse.
Integrazione con CMS italiani
Integrare il sistema con WordPress tramite plugin tecnici (es. “Advanced Content Validation”) o SharePoint con azioni personalizzate: i risultati annotati vengono inseriti automaticamente nei metadati, con suggerimenti di correzione in tempo reale. Caso studio: un’azienda manifatturiera piemontese ha ridotto del 40% gli errori di etichettatura e migliorato la coerenza dei report tecnici in 3 mesi, grazie a un’installazione modulare e feedback loop con linguisti.
—
Conclusioni e best practice per una governance semantica duratura
Il controllo qualità semantico automatico non è un processo unico, ma un ciclo iterativo che unisce Tier 1 (concetti base, regole linguistiche), Tier 2 (estrazione automatica con pipeline integrate) e Tier 3 (validazione ontologica, disambiguazione contestuale). Il Tier 2, grazie a strumenti come spaCy + custom NER e ontologie di settore, costituisce il fondamento su cui costruire coerenza e scalabilità. Tuttavia, solo integrando metodi avanzati di contestualizzazione — tra cui grafi della conoscenza italiane e disambiguazione basata su co-referenza — si raggiunge la precisione richiesta per contenuti tecnici professionali.
Más historias
PORTADA
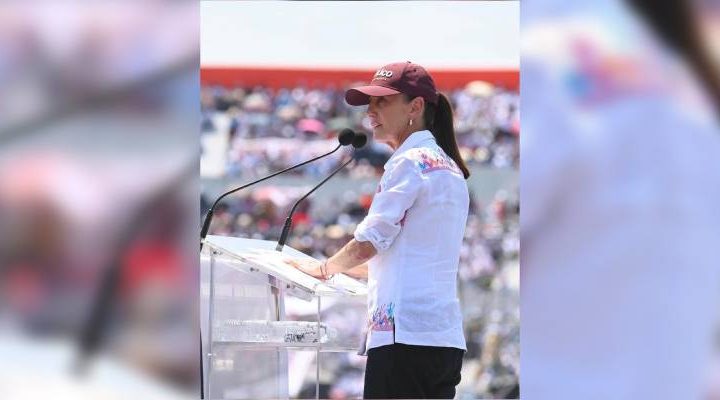
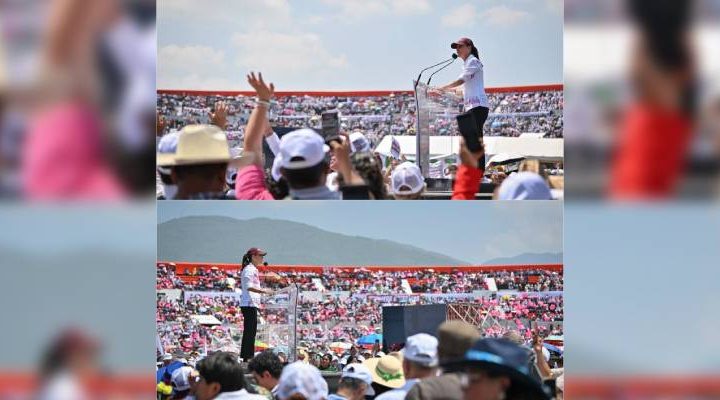
Nosotros somos gobiernos del pueblo: presidenta Claudia Sheinbaum ante cerca de 70 mil chiapanecos
Chiapas recibe con gratitud y los brazos abiertos a la presidenta Claudia Sheinbaum